RAG(검색 증강 생성)는 AI가 답하기 전에 질문과 관련된 문서를 먼저 찾아서 함께 건네주는 방식입니다. 결론부터 말하면, 사내 매뉴얼이나 상품 정보처럼 AI가 원래 모르는 자료를 근거로 답하게 하려면 RAG가 가장 손쉬운 방법이지만, 문서가 약 500쪽보다 적다면 RAG 없이 통째로 넣는 편이 더 간단하고 정확할 수 있습니다. 이 글은 2026년 10월 12일 기준 원 논문과 Anthropic·OpenAI·Supabase 공식 문서를 근거로 원리, 비용, 고르는 기준을 정리했습니다.
RAG란 정확히 무슨 뜻인가요?
RAG는 Retrieval-Augmented Generation의 약자로, 우리말로는 검색 증강 생성이라고 부릅니다. 이 이름은 2020년 5월 패트릭 루이스(Patrick Lewis) 등이 발표한 논문에서 나왔습니다. 논문의 구조는 단순합니다. 글을 만들어 내는 언어 모델 옆에 검색기를 붙여, 모델이 답하기 전에 위키백과에서 관련 내용을 찾아 보게 했습니다.
쉽게 비유하면 오픈북 시험입니다. 언어 모델은 학습할 때 본 내용만 기억하는 학생과 같아서, 학습 이후에 생긴 일이나 회사 내부 문서는 모릅니다. 모르는 것을 물으면 그럴듯하게 지어내기도 합니다. RAG는 시험 문제를 받을 때마다 관련된 교재 페이지를 같이 펼쳐 주는 방식이라, 모델을 다시 학습시키지 않고도 최신 자료와 사내 자료를 근거로 답하게 만듭니다.
그래서 어디에 쓰나요?
- 사내 문서 챗봇: 취업 규칙, 업무 매뉴얼, 제품 사양서를 근거로 직원 질문에 답하기
- 고객 응대: 상품 정보와 자주 묻는 질문을 근거로 상담 답변 초안 만들기
- 개발 문서 검색: 내부 API 문서와 코드에서 관련 부분을 찾아 설명하기
공통점은 답의 근거가 AI 바깥의 문서에 있고, 그 문서가 자주 바뀐다는 것입니다.
RAG는 어떤 순서로 동작하나요?
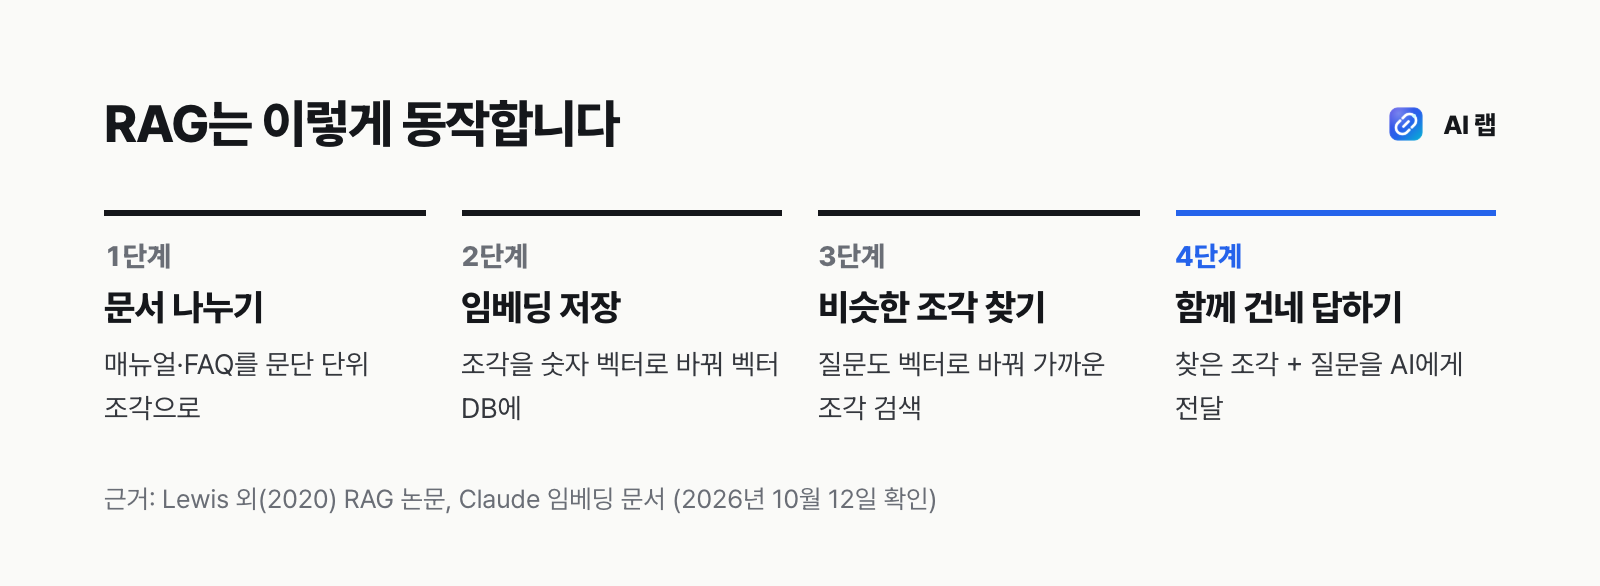
RAG는 미리 해 두는 준비 단계와, 질문이 들어올 때마다 도는 응답 단계로 나뉩니다.
준비 단계: 문서를 찾을 수 있게 만들기
먼저 문서를 문단 정도 크기의 조각(chunk) 으로 나눕니다. 그다음 각 조각을 임베딩으로 바꿉니다. 임베딩은 글의 의미를 숫자 목록(벡터)으로 바꾼 것으로, 뜻이 비슷한 글끼리는 숫자도 가깝게 나옵니다. 이렇게 만든 벡터를 원문 조각과 함께 벡터 DB에 저장합니다. 임베딩 모델과 벡터 DB를 고르는 기준은 임베딩과 벡터 DB 고르는 법에서 따로 다룹니다.
응답 단계: 찾아서 같이 건네기
질문이 들어오면 질문도 같은 방식으로 임베딩합니다. 벡터 DB에서 질문 벡터와 가장 가까운 조각 몇 개를 찾고, 그 조각들을 질문과 함께 AI에게 보내 "아래 자료를 근거로 답하라"고 요청합니다. 답에 근거 문서의 출처를 붙여 보여 줄 수 있는 것도 이 구조 덕분입니다.
참고
Claude를 만드는 Anthropic은 자체 임베딩 모델을 제공하지 않습니다. 공식 문서는 Voyage AI를 한 예로 소개하면서 여러 업체를 비교해 보라고 안내합니다. 즉 답변은 Claude, 임베딩은 다른 업체처럼 섞어 쓰는 구성이 흔합니다. 답변 쪽 모델 단가는 클로드 요금제 정리와 OpenAI API 가격 정리에서 비교할 수 있습니다.
RAG와 파인튜닝, 긴 문맥은 어떻게 고르나요?
AI에게 새로운 지식을 쓰게 하는 방법은 RAG만 있는 것이 아닙니다. 문서 몇 개를 근거로 묻는 정도라면 노트북LM처럼 RAG가 이미 들어 있는 도구로 충분할 수도 있습니다. 직접 만든다면 자주 비교되는 세 가지를 나란히 놓으면 이렇습니다.
| 구분 | RAG | 파인튜닝 | 긴 문맥(통째로 넣기) |
|---|---|---|---|
| 하는 일 | 질문마다 관련 조각만 찾아 붙임 | 예시 데이터로 모델을 추가 학습 | 문서 전체를 매번 프롬프트에 넣음 |
| 잘 맞는 일 | 문서가 많고 자주 바뀌는 지식 | 말투·형식·작업 방식 익히기 | 문서가 적고 자주 바뀌지 않는 경우 |
| 자료가 바뀌면 | 바뀐 조각만 다시 임베딩 | 다시 학습해야 반영 | 넣는 문서만 바꾸면 끝 |
| 출처 표시 | 쉬움(찾은 조각이 곧 근거) | 어려움 | 가능하지만 범위가 넓음 |
| 만드는 수고 | 중간(나누기·저장·검색 설계) | 큼(데이터 정리·학습·평가) | 작음 |
먼저 '통째로 넣기'부터 따져 보세요
Anthropic은 Contextual Retrieval을 소개한 글(2024년 9월)에서 지식 베이스가 20만 토큰, 약 500쪽보다 작다면 전체를 프롬프트에 그냥 넣어도 된다고 안내합니다. 같은 문서를 매번 보내는 비용은 프롬프트 캐싱으로 줄일 수 있습니다. 검색 단계가 없으니 "관련 조각을 못 찾아서 틀리는" 실패도 생기지 않습니다.
그래서 순서는 이렇게 권합니다. 문서가 적으면 통째로 넣기, 문서가 많거나 계속 늘어나면 RAG, 지식이 아니라 말투와 형식을 바꾸고 싶다면 파인튜닝입니다. 셋은 함께 쓸 수도 있어서, RAG로 찾은 자료를 파인튜닝한 모델에 건네는 구성도 가능합니다. 파인튜닝을 언제 고르는지와 학습 비용은 파인튜닝이란?에 따로 정리했습니다.
RAG 비용은 어디서 얼마나 나오나요?
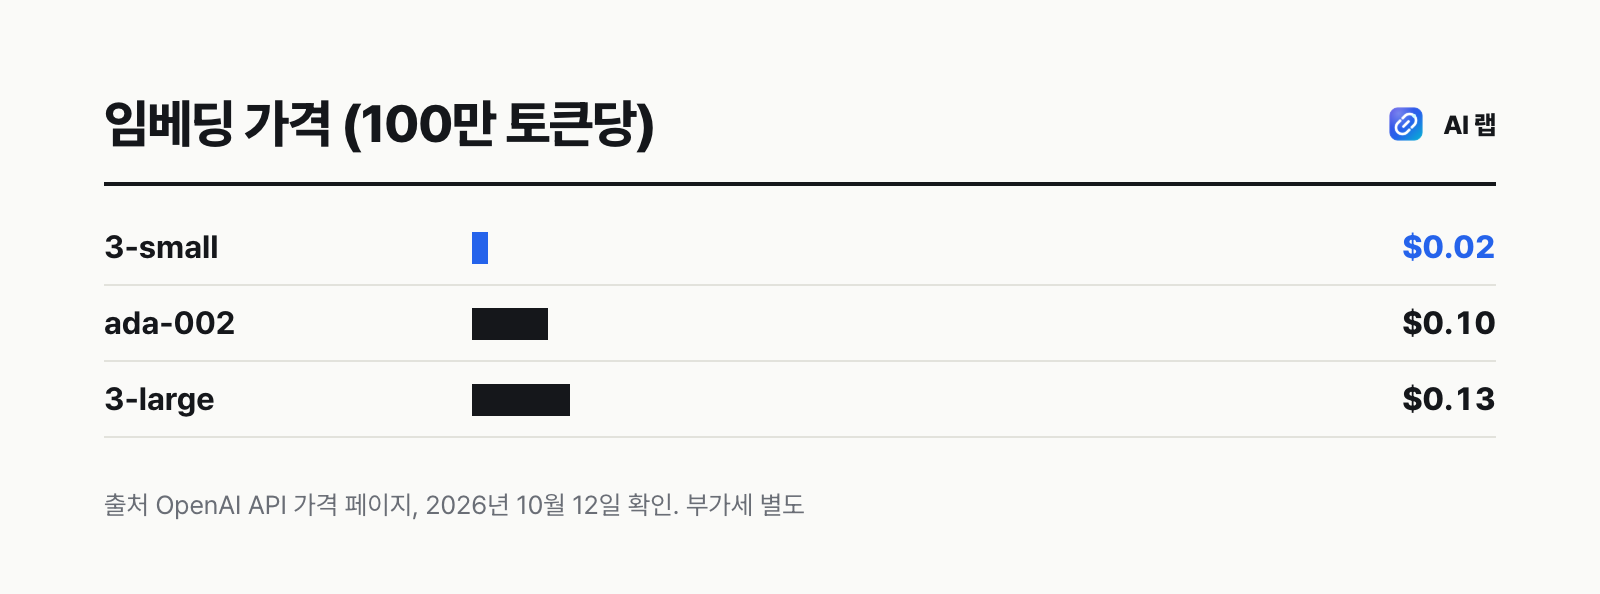
RAG 비용은 세 갈래로 나뉩니다. 각각 성격이 달라서 따로 계산해야 합니다.
임베딩: 생각보다 작습니다
2026년 10월 12일 OpenAI 공식 가격 기준으로 text-embedding-3-small은 100만 토큰당 0.02달러, text-embedding-3-large는 0.13달러입니다. 앞에서 본 Anthropic의 기준(약 500쪽 ≈ 20만 토큰)을 그대로 쓰면, 500쪽 분량을 3-small로 한 번 임베딩하는 비용은 약 0.004달러입니다. 문서가 바뀔 때 해당 조각만 다시 임베딩하면 되므로 이 비용이 전체에서 차지하는 몫은 대개 작습니다.
저장: 이미 쓰는 DB가 있다면 거기에
벡터 DB를 따로 계약하지 않아도 됩니다. Supabase는 Postgres 확장인 pgvector로 벡터를 저장하고 검색할 수 있고, 대시보드의 Extensions 메뉴에서 vector를 켜면 바로 씁니다. Supabase 무료 플랜은 프로젝트당 데이터베이스 500MB, Pro 플랜은 월 25달러부터이며 디스크 8GB가 포함됩니다(2026년 10월 12일 확인). 이 블로그도 Supabase로 운영하고 있어서, 비슷한 서비스라면 같은 데이터베이스에 테이블 하나를 더 만드는 정도로 시작할 수 있습니다. 데이터베이스와 서버 구성은 서버·아키텍처 글에서 이어집니다.
답변 생성: 비용 대부분이 여기서 나옵니다
질문마다 찾은 조각 여러 개를 AI에게 함께 보내므로, 입력 토큰 = 질문 + 붙인 조각 전체가 됩니다. 조각을 5개 붙이느냐 20개 붙이느냐에 따라 질문 한 번의 비용이 몇 배로 달라집니다. 그래서 RAG 비용을 줄이는 핵심은 임베딩 모델을 싼 것으로 바꾸는 것보다 붙이는 조각 수와 크기를 줄이는 것입니다. 모델별 입력·출력 단가와 프롬프트 캐싱으로 줄이는 법은 AI 비용 절감 글에서 따로 다룹니다.
RAG를 직접 만들려면 무엇부터 해야 할까요?
처음부터 완벽한 구성을 설계하기보다, 작은 문서 묶음으로 한 바퀴를 끝까지 돌려 보는 것이 좋습니다.
1. 질문 목록부터 만듭니다
사용자가 실제로 물을 질문 20~30개와 모범 답을 먼저 적어 둡니다. 이 목록이 있어야 조각 크기를 바꾸거나 모델을 바꿨을 때 좋아졌는지 나빠졌는지 판단할 수 있습니다. RAG가 잘 안 되는 원인의 대부분은 "무엇이 정답인지 정해 두지 않은 것"에서 나옵니다.
2. 조각은 의미 단위로 나눕니다
글자 수로 기계적으로 자르면 표나 목록이 중간에 끊겨 엉뚱한 조각이 검색됩니다. 제목·문단 단위로 나누고, 각 조각에 문서 제목 같은 맥락을 붙이면 검색이 좋아집니다. Anthropic이 소개한 Contextual Retrieval이 바로 이 방법으로, 조각마다 문서 맥락 설명을 덧붙여 검색 실패를 49%, 리랭킹과 함께 쓰면 67% 줄였다고 밝혔습니다.
3. 검색과 답변을 따로 확인합니다
틀린 답이 나오면 먼저 검색된 조각에 정답이 있었는지 봅니다. 없었다면 검색 문제(조각 나누기·임베딩), 있었는데 틀렸다면 답변 문제(프롬프트·모델)입니다. 둘을 나눠 보지 않으면 엉뚱한 곳을 고치느라 시간을 씁니다.
RAG가 안 통하거나 필요 없는 경우는 언제인가요?
RAG는 만능이 아닙니다. 아래 경우에는 다른 방법이 낫거나, 아예 만들지 않는 편이 낫습니다.
- 문서가 적을 때: 약 500쪽(20만 토큰) 이하라면 통째로 넣는 쪽이 만들기도 쉽고 검색 실패도 없습니다.
- 전체를 훑어야 하는 질문: "작년 계약서 전체에서 위약금 조항을 모두 비교해 줘"처럼 문서 전체를 봐야 하는 질문은, 몇 개 조각만 찾아 붙이는 RAG가 놓치기 쉽습니다.
- 원본 문서가 정리되어 있지 않을 때: 서로 다른 버전의 매뉴얼이 섞여 있으면 RAG는 옛 버전을 근거로 자신 있게 틀린 답을 합니다. 문서 정리가 먼저입니다.
- 말투나 형식을 바꾸고 싶을 때: 지식이 아니라 답변 스타일이 문제라면 RAG로는 해결되지 않습니다. 프롬프트나 파인튜닝 쪽 문제입니다.
- 권한이 다른 문서가 섞일 때: 인사 자료처럼 볼 수 있는 사람이 정해진 문서를 한 벡터 DB에 넣으면, 권한 없는 사용자의 질문에도 그 조각이 검색될 수 있습니다. 검색 단계에서 사용자 권한으로 걸러야 합니다.
그래서 RAG는 어떻게 시작하면 될까요?
정리하면 판단 순서는 세 단계입니다. 첫째, 근거로 쓸 문서가 약 500쪽보다 적으면 RAG 없이 통째로 넣기부터 시험합니다. 둘째, 문서가 많거나 계속 늘어난다면 이미 쓰는 데이터베이스(예: Supabase pgvector)에 벡터를 저장하는 가장 단순한 RAG를 만들고, 미리 적어 둔 질문 목록으로 검색과 답변을 따로 확인합니다. 셋째, 비용은 임베딩보다 질문마다 붙이는 조각의 양에서 커지므로 그 부분부터 줄입니다. 다른 AI 자동화 사례는 AI 업무 자동화에서, 이 블로그를 누가 운영하는지는 블로그 소개에서 볼 수 있습니다.