임베딩은 문장을 뜻이 담긴 숫자 목록으로 바꾸는 일입니다. 결론부터 말하면, 처음 의미 검색을 붙인다면 값싼 임베딩 모델 하나와 이미 쓰고 있는 Postgres(Supabase라면 pgvector)로 충분하고, 전용 벡터 DB는 벡터가 아주 많아진 다음에 고민해도 됩니다. 이 글은 2026년 10월 12일 기준 OpenAI·Google·Hugging Face·Supabase·pgvector 공식 문서를 근거로 정리했습니다.
임베딩이란 쉽게 말해 무엇인가요?
임베딩(embedding)은 글을 수백~수천 개의 숫자로 된 좌표로 바꾼 것입니다. 지도에서 가까운 두 지점이 실제로도 가까운 것처럼, 임베딩 공간에서 가까운 두 문장은 뜻이 비슷합니다. "환불하고 싶어요"와 "결제 취소 방법"은 겹치는 단어가 없지만 임베딩으로 바꾸면 서로 가까운 자리에 놓입니다.
그래서 임베딩은 키워드 검색이 놓치는 것을 찾는 데 씁니다.
- 의미 검색: 질문과 뜻이 비슷한 문서 찾기
- RAG: AI에게 답의 근거가 될 문서 조각을 골라 건네기 (RAG의 원리와 비용에서 전체 흐름을 다뤘습니다)
- 분류·묶기: 비슷한 문의나 리뷰끼리 모으기, 중복 글 찾기
가깝다는 것은 어떻게 재나요?
보통 코사인 유사도를 씁니다. 두 벡터가 가리키는 방향이 얼마나 비슷한지를 재는 값으로, 1에 가까울수록 뜻이 비슷합니다. OpenAI 문서도 임베딩 비교에 코사인 유사도를 권장하고, Supabase의 예제 검색 함수도 pgvector의 코사인 거리 연산자(<=>)로 1 - 거리를 유사도로 씁니다.
임베딩 모델은 어떻게 고르면 될까요?
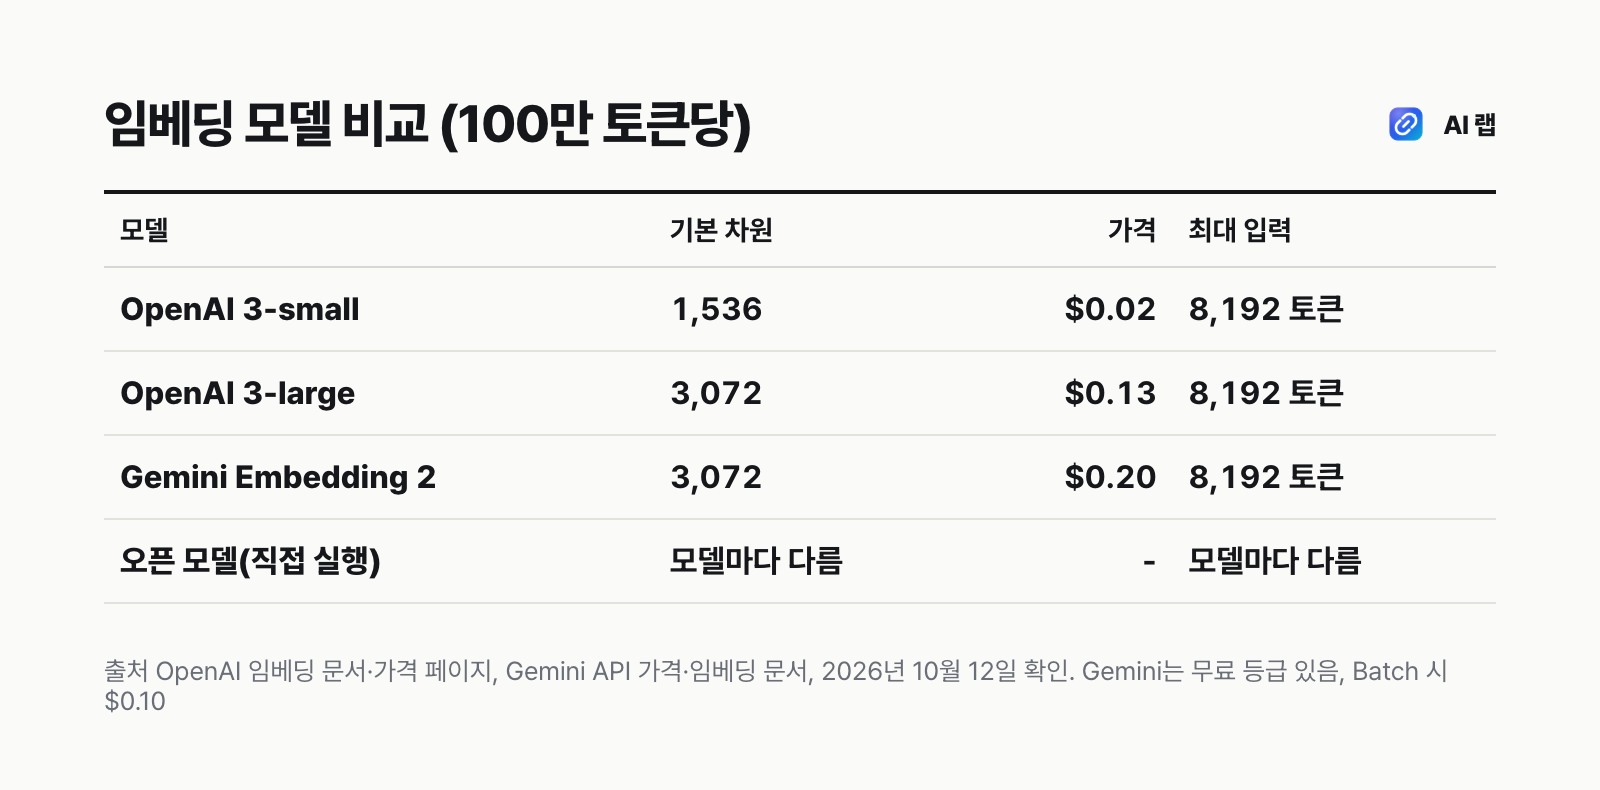
선택지는 크게 세 갈래입니다.
| 선택지 | 비용 | 장점 | 주의할 점 |
|---|---|---|---|
| OpenAI text-embedding-3-small | 100만 토큰당 $0.02 | 싸고 무난, 1536차원 | API 키·외부 전송 |
| OpenAI text-embedding-3-large | 100만 토큰당 $0.13 | 더 큰 3072차원 | 저장·인덱스 부담 |
| Google Gemini Embedding 2 | 100만 토큰당 $0.20, 무료 등급 있음 | 이미지·음성도 같은 공간에 | 무료 등급은 쓰임 조건 확인 |
| 오픈 모델(Hugging Face) | 모델 사용료 없음, 서버 비용은 직접 | 데이터가 밖으로 안 나감 | 직접 띄우고 관리 |
가격은 2026년 10월 12일 각 공식 가격표 기준이고 부가세는 별도입니다. API 가격 전반은 OpenAI API 가격 정리에 모아 두었습니다.
임베딩 비용은 실제로 얼마나 나오나요?
생각보다 작습니다. OpenAI는 한 쪽을 약 800토큰으로 잡고 3-small이면 1달러로 약 62,500쪽을 임베딩할 수 있다고 안내합니다. 문서를 처음 한 번 넣는 비용은 대개 문제가 되지 않고, 비용이 커지는 쪽은 저장 용량과 이후의 AI 답변 생성입니다.
오픈 모델은 언제 쓰나요?
Hugging Face Hub에는 sentence-transformers 형식의 임베딩 모델이 500개 넘게 올라와 있고, SentenceTransformer('모델명') 한 줄로 내려받아 내 서버에서 돌릴 수 있습니다. 고객 데이터를 외부 API로 보내기 어려운 경우에 맞습니다. 다만 한국어 성능은 모델마다 차이가 크니 모델 카드를 보고 직접 비교해야 합니다. Hub 사용법은 허깅페이스 사용법에 따로 정리했습니다.
질문과 문서를 같은 방식으로 임베딩하면 되나요?
모델에 따라 다릅니다. 검색에서는 짧은 질문과 긴 문서를 비교하기 때문에, 둘을 구분해서 넣으라고 안내하는 모델이 있습니다. 구글의 이전 텍스트 모델(gemini-embedding-001)은 task_type에 질문용 RETRIEVAL_QUERY와 문서용 RETRIEVAL_DOCUMENT를 따로 지정하고, Gemini Embedding 2는 이 파라미터 대신 텍스트 앞에 task: search result | query: 같은 작업 접두어를 붙이는 방식입니다. 모델 문서의 권장 방식을 따르지 않으면 같은 모델이라도 검색 품질이 떨어질 수 있으니, 연동 코드를 짤 때 이 부분부터 확인하세요.
차원 수는 왜 중요하고, 어떻게 정할까요?
차원은 벡터 하나가 가진 숫자 개수입니다. 차원이 높을수록 미묘한 차이를 담을 여지는 커지지만, 저장 용량과 검색 비용이 그만큼 늘어납니다.
다행히 두 회사 모두 차원을 줄여 받을 수 있습니다. OpenAI는 dimensions 파라미터로 벡터를 짧게 받을 수 있고, Gemini Embedding 2는 128~3072 사이에서 고를 수 있으며 768·1536·3072를 권장합니다. 줄인 벡터는 자동으로 정규화됩니다.
주의
모델이나 차원을 바꾸면 기존 벡터와 새 벡터를 섞어 비교할 수 없습니다. 바꿀 때는 저장된 문서를 전부 다시 임베딩해야 하니, 처음에 작은 표본으로 검색 품질을 비교해 보고 정하세요.
벡터는 어디에 저장해야 할까요?
이미 Postgres를 쓰고 있다면 pgvector 확장이 가장 단순합니다. 이 블로그도 Supabase(Postgres)로 운영하는데, Supabase에서는 대시보드의 Extensions에서 vector를 켜고 테이블에 vector(384) 같은 열을 추가하면 됩니다.
create extension vector with schema extensions;

create table documents (
  id bigserial primary key,
  content text,
  embedding extensions.vector(1536)
);
검색은 질문을 같은 모델로 임베딩한 뒤, 코사인 거리가 가까운 순서로 몇 개를 꺼내는 쿼리 한 줄입니다. Supabase 예제처럼 이 쿼리를 match_documents 같은 데이터베이스 함수로 감싸 두면 앱에서는 함수 하나만 호출하면 됩니다.
select id, content, 1 - (embedding <=> $1) as similarity
from documents
order by embedding <=> $1
limit 5;
검색이 느려지면 인덱스를 붙입니다. Supabase 문서는 HNSW를 기본 인덱스로 권장하며, 테이블을 만든 직후에 만들어 두어도 새 행이 자동으로 색인된다고 안내합니다.
전용 벡터 DB는 언제 필요할까요?
벡터 수가 아주 많아 Postgres 한 대로 감당하기 어렵거나, 검색 지연 자체가 제품의 핵심일 때입니다. 처음부터 별도 서비스를 붙이면 데이터가 두 곳에 나뉘어 동기화와 권한 관리가 늘어납니다. 원문과 벡터가 같은 테이블에 있으면 "이 사용자 문서 중에서만 검색" 같은 조건을 SQL 한 줄로 걸 수 있다는 장점도 큽니다.
저장 용량은 어떻게 계산하나요?
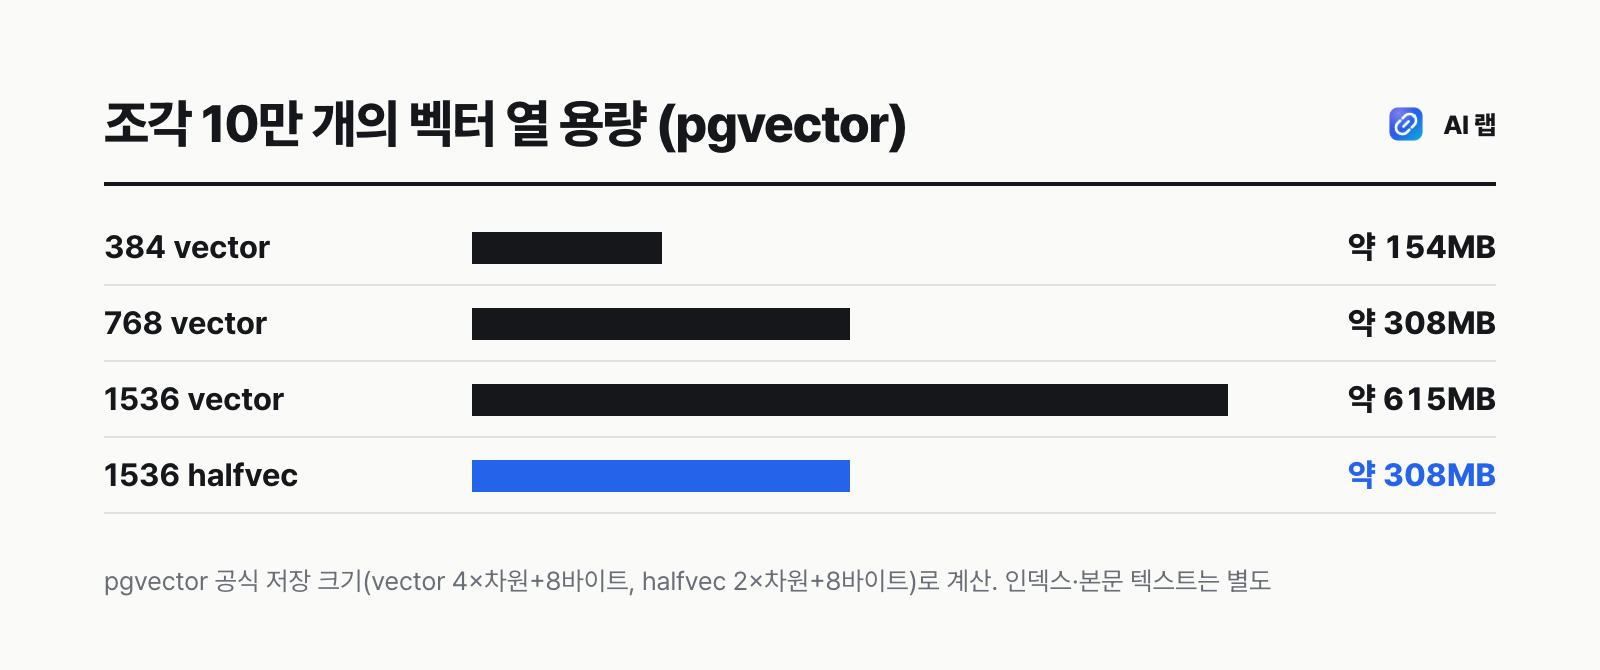
pgvector 공식 문서에 따르면 vector는 4×차원+8바이트, 절반 정밀도인 halfvec은 2×차원+8바이트를 씁니다. 문서 조각 10만 개를 1536차원으로 저장하면 벡터 열만 약 615MB입니다. 여기에 인덱스와 본문 텍스트가 더해집니다.
이 숫자가 중요한 이유는 요금제 한도 때문입니다. Supabase 무료 플랜의 데이터베이스는 500MB라서, 1536차원 조각 10만 개는 벡터만으로 한도를 넘습니다. 같은 차원을 halfvec로 저장하거나 차원을 768로 줄이면 약 308MB로 절반이 됩니다. 요금제별 한도는 수파베이스 무료 플랜 정리를 참고하세요.
임베딩 검색이 안 통하는 경우는 언제일까요?
- 정확한 값을 찾을 때: 주문번호, 상품 코드, 사람 이름처럼 글자가 정확히 맞아야 하는 검색은 임베딩보다 일반 검색(LIKE, 전문 검색)이 낫습니다. 실무에서는 둘을 섞는 경우가 많습니다.
- 3072차원을 그대로 인덱스하려 할 때: pgvector에서 vector 타입 인덱스는 2,000차원까지입니다. 3072차원은 halfvec(4,000차원까지)로 바꾸거나 차원을 줄여야 합니다.
- 문서가 아주 적을 때: 수십 쪽이면 임베딩과 벡터 DB 없이 문서를 통째로 AI에 넣는 편이 더 간단하고 정확합니다.
- 조각을 잘못 나눴을 때: 한 조각에 여러 주제가 섞이거나 문장 중간에서 잘리면, 모델이 좋아도 엉뚱한 조각이 검색됩니다. 문단·소제목 단위로 나누는 것부터 점검합니다.
정리: 처음 임베딩을 붙인다면 무엇부터 할까요?
- 검색 대상이 수십 쪽 이하인지 먼저 봅니다. 그렇다면 임베딩 없이 시작합니다.
- 임베딩이 필요하면 값싼 모델(OpenAI 3-small 또는 Gemini 무료 등급)과 적당한 차원(768~1536)으로 시작합니다.
- 이미 Postgres·Supabase를 쓴다면 pgvector 열과 HNSW 인덱스로 붙입니다.
- 조각 수 × (4×차원+8바이트)로 용량을 계산해 요금제 한도와 비교하고, 넘치면 halfvec이나 차원 축소를 씁니다.
- 표본 질문 20~30개로 검색 결과를 직접 확인한 뒤에 모델과 차원을 확정합니다.