올라마(Ollama)는 오픈소스 LLM을 내 컴퓨터나 서버에서 명령어 한 줄로 내려받아 돌리게 해 주는 도구입니다. 결론부터 말하면 API 요금 없이, 데이터를 밖으로 보내지 않고 모델을 써야 할 때 올라마가 가장 빠른 길이고, 성능이 중요한 업무나 사람이 몰리는 서비스라면 여전히 클라우드 API가 쌉니다. 이 글의 명령어와 수치는 2026년 10월 12일 올라마 공식 문서와 모델 라이브러리에서 확인한 값입니다.
올라마는 무엇이고 왜 쓰나요?
LLM을 직접 돌리려면 원래 모델 가중치를 받고, 양자화 형식을 맞추고, GPU 드라이버와 추론 엔진을 설정해야 합니다. 올라마는 이 과정을 ollama run 모델이름 하나로 줄여 줍니다. 모델은 올라마 라이브러리(ollama.com/library)에서 받고, 받으면 곧바로 터미널에서 대화하거나 API로 부를 수 있습니다.
쓰는 이유는 대개 셋입니다.
- 비용: 내 하드웨어에서 돌리는 사용량은 공식 가격 페이지 기준 항상 무제한입니다. 토큰당 요금이 없습니다.
- 데이터: 공식 FAQ는 로컬로 실행할 때 프롬프트와 데이터를 보지 않는다고 밝힙니다. 사내 문서를 외부 API에 보내기 어려운 경우에 맞습니다.
- 오프라인·실험: 모델을 바꿔 가며 비교하거나 인터넷이 막힌 환경에서 돌릴 수 있습니다.
모델 자체를 찾고 비교하는 단계라면 허깅페이스 사용법에서 다룬 Hub가 더 넓고, 올라마는 "받아서 바로 실행"에 특화돼 있다고 보면 됩니다.
올라마는 어떻게 설치하고 실행하나요?
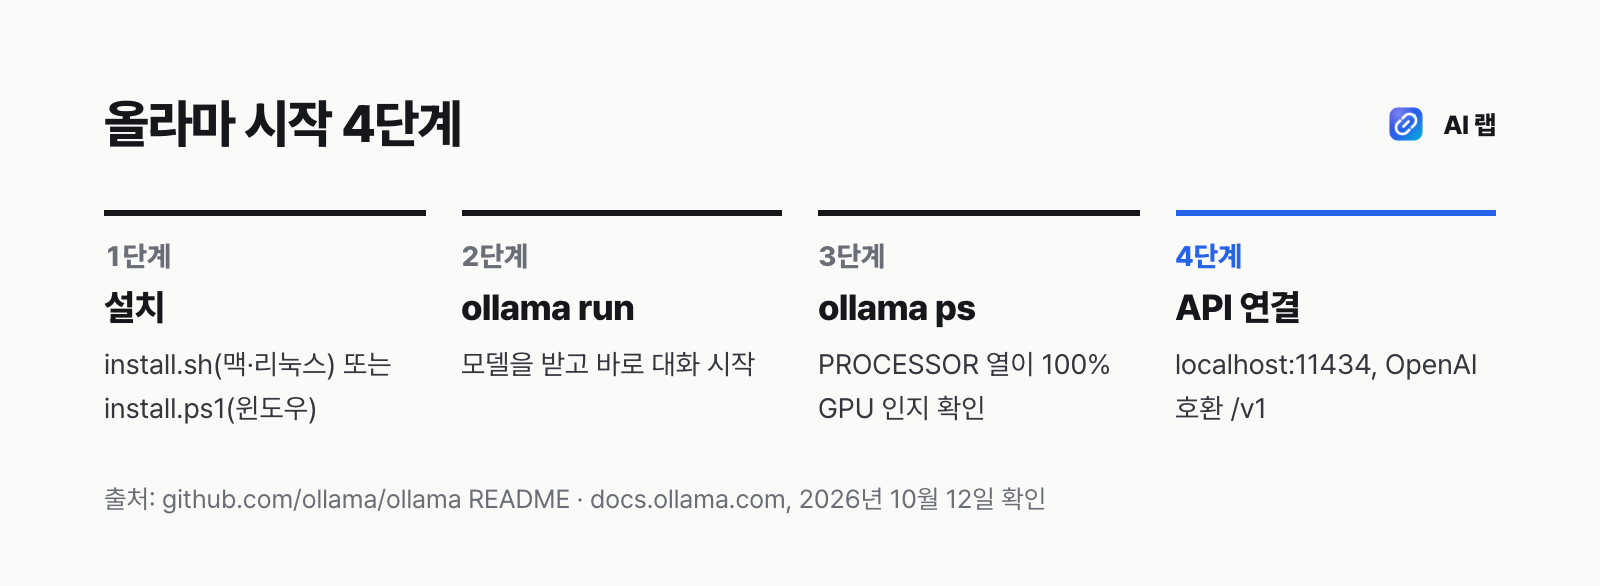
공식 README 기준 설치 명령은 다음과 같습니다. 각 운영체제용 설치 파일을 직접 받는 링크도 다운로드 페이지에 있습니다.
# macOS · Linux
curl -fsSL https://ollama.com/install.sh | sh

# Windows (PowerShell)
irm https://ollama.com/install.ps1 | iex
설치가 끝나면 모델을 받아 바로 대화합니다. README의 빠른 시작 예시는 Gemma 4입니다.
ollama run gemma4      # 처음이면 내려받은 뒤 대화 시작
ollama ps              # 지금 메모리에 올라간 모델과 GPU 사용 여부
ollama list            # 받아 둔 모델 목록
모델은 마지막 요청 뒤 기본 5분 동안 메모리에 남아 있다가 내려갑니다. 자주 쓰면 keep_alive 또는 OLLAMA_KEEP_ALIVE로 늘리고, 메모리를 빨리 비워야 하면 줄입니다.
내 컴퓨터에서 어떤 크기 모델까지 돌아갈까요?
올라마 공식 문서는 "몇 B 모델에 몇 GB"라는 표를 주지 않습니다. 대신 모델 태그 페이지에 다운로드 용량이 나오고, 이것이 판단의 출발점입니다.
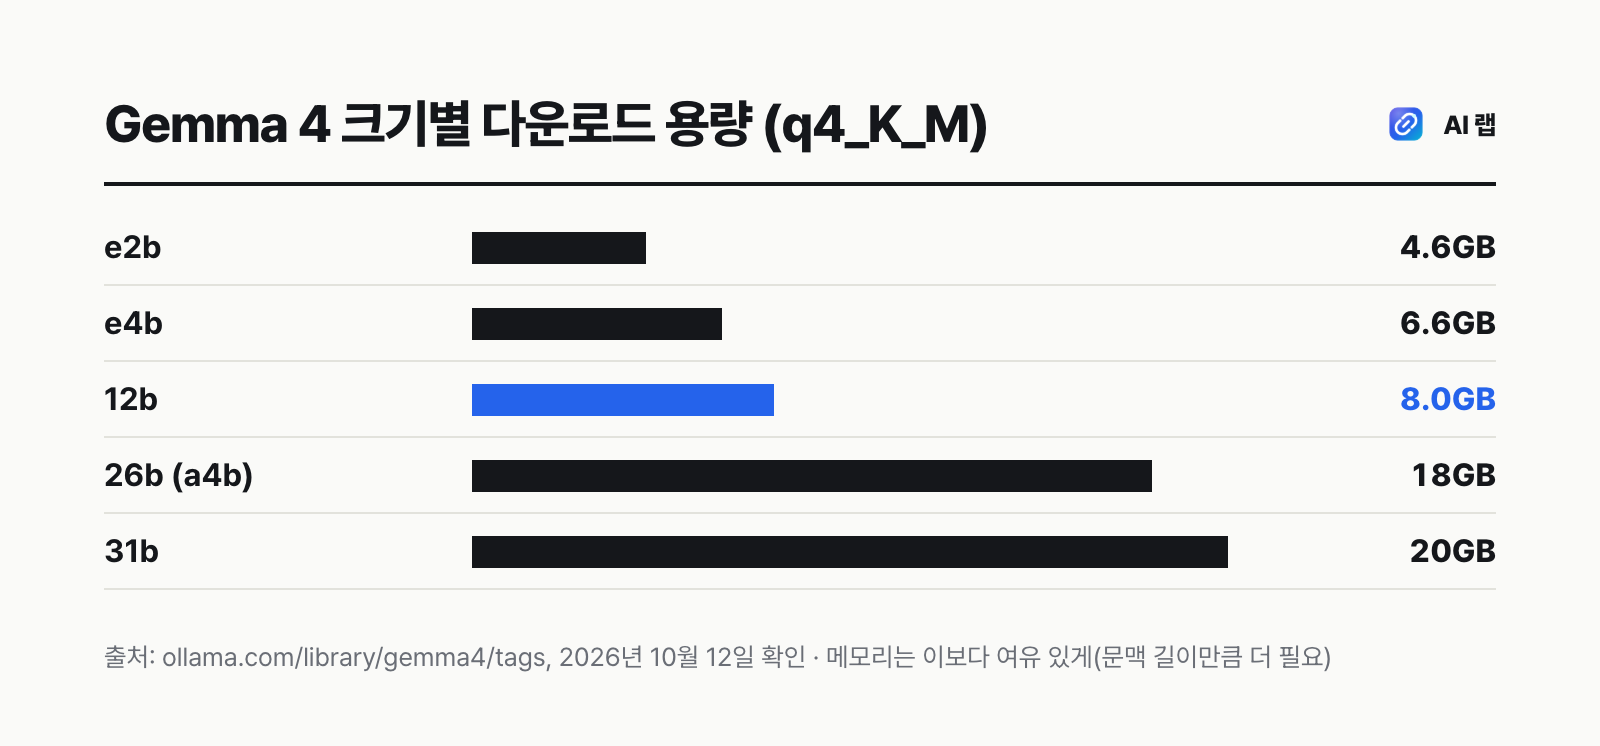
메모리를 판단하는 순서
- 태그 페이지에서 쓰려는 버전의 용량을 봅니다. 같은 Gemma 4 12b라도 q4_K_M은 8.0GB, bf16은 24GB입니다. 양자화가 낮을수록 작고, 품질은 조금 떨어질 수 있습니다.
- GPU 메모리(맥은 통합 메모리)가 그 용량보다 여유 있게 남는지 봅니다. 문맥 길이를 늘리면 그만큼 더 필요합니다. 올라마 기본 문맥은 4096토큰이고
OLLAMA_CONTEXT_LENGTH나num_ctx로 바꿉니다. - 실제로 받아서
ollama ps를 칩니다. PROCESSOR 열이100% GPU면 전부 GPU에 올라간 것이고, CPU가 섞여 있으면 메모리가 모자라 속도가 크게 떨어지는 상태입니다.
지원 하드웨어
| 하드웨어 | 공식 문서 조건 |
|---|---|
| NVIDIA | compute capability 5.0 이상, 드라이버 550 이상(5.0~6.2는 570 이상) |
| AMD Radeon | 리눅스 ROCm v7 드라이버, 윈도우 ROCm v7·HIP7 드라이버 |
| 애플 실리콘 | Metal API로 GPU 가속 |
GPU가 없어도 CPU로 돌아가지만, 작은 모델이 아니면 응답이 느려 실사용이 어렵습니다.
태그 이름은 어떻게 읽나요?
같은 모델도 태그마다 용량이 크게 다릅니다. Gemma 4 태그 페이지를 예로 들면 다음과 같습니다.
| 태그 끝부분 | 뜻 | 12b 기준 용량 |
|---|---|---|
bf16 |
원본에 가까운 16비트 가중치 | 24GB |
q8_0 |
8비트 양자화 | 13GB |
q4_K_M |
4비트 양자화(기본 태그가 주로 이쪽) | 8.0GB |
qat |
양자화를 고려해 학습한 4비트 버전 | 7.2GB |
처음에는 태그 없이 받는 기본값(gemma4)으로 시작하고, 메모리가 남으면 한 단계 큰 모델로, 모자라면 한 단계 작은 크기로 바꾸는 순서가 시행착오가 적습니다. 숫자가 큰 모델의 4비트 버전과 숫자가 작은 모델의 8비트 버전 중 무엇이 나은지는 작업마다 다르니, 실제로 쓸 질문 몇 개로 직접 비교해 보는 것이 정확합니다. 로컬 AI용으로 맥을 새로 산다면 메모리 고르는 기준은 맥미니 AI 돌리는법에 정리했습니다.
느리거나 답이 끊길 때 확인할 것
ollama ps에 CPU가 섞여 있다: 메모리 부족입니다. 더 작은 태그로 바꾸거나 다른 프로그램을 닫습니다.- 긴 문서를 넣었는데 앞부분을 잊는다: 기본 문맥 4096토큰을 넘은 것입니다.
num_ctx를 늘리되, 늘린 만큼 메모리를 더 씁니다. - 첫 응답만 유독 느리다: 모델을 메모리에 올리는 시간입니다. 5분 뒤 자동으로 내려가므로 자주 쓰면
keep_alive를 늘립니다.
올라마를 API로 내 앱에 연결하려면 어떻게 하나요?
올라마는 실행 중이면 127.0.0.1:11434에서 API 서버가 함께 돕니다. 공식 문서는 두 가지 방법을 줍니다.
curl http://localhost:11434/api/chat -d '{
  "model": "gemma4",
  "messages": [{ "role": "user", "content": "올라마를 한 문장으로 설명해 줘" }]
}'
이미 OpenAI SDK로 짠 코드가 있다면 주소만 바꾸면 됩니다.
import OpenAI from "openai";

const client = new OpenAI({ baseURL: "http://localhost:11434/v1/", apiKey: "ollama" }); // 키 값은 무시된다
const res = await client.chat.completions.create({ model: "gemma4", messages: [{ role: "user", content: "안녕" }] });
공식 호환 엔드포인트는 chat/completions, completions, models, embeddings, responses입니다. embeddings가 있어서 RAG(검색 증강 생성)의 임베딩 단계를 로컬 모델로 처리하는 구성도 가능합니다.
주의
다른 기기에서 접속하려고 OLLAMA_HOST를 0.0.0.0으로 바꾸면 같은 네트워크의 누구나 내 모델을 쓸 수 있습니다. 서버에 올릴 때는 방화벽이나 리버스 프록시 인증을 함께 둡니다. 컨테이너로 묶어 배포하는 기본은 도커 입문을 참고하세요.
로컬 LLM이 클라우드 API보다 정말 싼가요?
토큰당 요금만 보면 로컬은 0원입니다. 하지만 비교 대상은 "하드웨어와 전기, 내 시간"입니다. 2026년 10월 공식 가격표 기준 Claude Haiku 5.5와 GPT-6 Luna는 100만 토큰당 입력 $0.10, 출력 $0.50입니다(OpenAI API 가격 정리 참고). 이 단가라면 개인이나 작은 팀이 한 달에 쓰는 양은 대개 몇 달러 수준이라, 이것만을 위해 GPU를 사는 것은 맞지 않습니다.
로컬이 이기는 경우는 정해져 있습니다.
| 상황 | 더 나은 쪽 | 이유 |
|---|---|---|
| 사내 문서를 외부로 보낼 수 없음 | 올라마(로컬) | 데이터가 기기를 떠나지 않음 |
| 이미 GPU 장비가 있고 대량 일괄 처리 | 올라마(로컬) | 추가 비용이 전기료뿐 |
| 최신 대형 모델 수준의 품질 필요 | 클라우드 API | 로컬에서 돌릴 수 있는 크기를 넘음 |
| 사용자가 동시에 몰리는 서비스 | 클라우드 API | 한 대의 GPU로는 동시 처리에 한계 |
| 가끔 쓰는 개인 용도 | 클라우드 API | 토큰 단가가 하드웨어 값보다 훨씬 쌈 |
싼 클라우드 모델의 데이터 정책이 걸린다면 딥시크 API 가격과 개인정보 처리에서 정리한 것처럼, 가격만이 아니라 데이터가 어디서 처리되는지도 같이 봐야 합니다.
올라마 클라우드 요금제는 무엇인가요?
올라마는 로컬 실행 외에 큰 모델을 대신 돌려 주는 클라우드도 팝니다. 로컬과 같은 명령어·API로 :cloud 태그 모델을 부르는 방식입니다.
| 요금제 | 월 요금 | 포함 내용(공식 가격 페이지) |
|---|---|---|
| Free | $0 | 로컬 실행, 시작용 크레딧, 클라우드는 종량 크레딧 |
| Pro | $20 (연 $200) | 월 $60 사용 크레딧, 더 큰 모델, 여러 모델 동시 실행 |
| Max | $100 | 월 $300 사용 크레딧, 동시 요청 10개 |
| Team | $500 | 사용자 무제한, 팀 공유 월 $1,000 크레딧 |
로컬만 쓸 거라면 유료 요금제는 필요 없습니다. 클라우드 기능을 아예 끄고 싶으면 OLLAMA_NO_CLOUD=1을 설정합니다.
올라마가 맞지 않는 경우는 언제인가요?
- 노트북 메모리가 8GB 안팎: 작은 모델(e2b급)만 실용적이고, 그 품질로 업무를 맡기기는 어렵습니다.
- 답의 정확도가 중요한 업무: 계약서 검토, 고객 응대처럼 틀리면 비용이 큰 일은 상위 클라우드 모델이 안전합니다.
- 24시간 서비스 백엔드: 서버에 GPU를 붙여 운영하면 장비 임대료가 API 요금보다 커지기 쉽고, 장애 대응도 직접 해야 합니다.
- 디스크가 부족한 기기: 모델 하나가 수~수십 GB입니다. 저장 위치는
OLLAMA_MODELS로 옮길 수 있습니다. - 명령어보다 화면으로 다루고 싶은 경우: 같은 로컬 실행을 앱 화면에서 하는 LM스튜디오 사용법이 더 편할 수 있습니다.
AI 기능을 실제 서비스에 넣을 때 로컬 모델과 API 중 무엇을 쓸지는 트래픽과 데이터 조건에 따라 달라집니다. 운영까지 고려한 구성이 필요하면 상담을 받아 보세요.
정리: 올라마는 어떻게 시작하면 될까요?
- 설치 스크립트로 올라마를 깔고
ollama run gemma4로 작은 모델부터 돌려 봅니다. ollama ps로 100% GPU인지 확인하고, 모자라면 더 작은 크기나 낮은 양자화로 내립니다.- 쓸 만하면
localhost:11434/v1로 기존 코드에 연결합니다. - 품질이나 동시 처리가 모자라면 그 작업만 클라우드 API로 넘깁니다. 로컬과 API를 같이 쓰는 것이 대부분의 경우 가장 현실적입니다.