맥미니 AI 구성에서 성능보다 먼저 정해야 하는 것은 통합 메모리 크기입니다. 모델 파일이 메모리에 통째로 올라가야 하기 때문에, 메모리가 돌릴 수 있는 모델의 크기를 정합니다. 결론부터 말하면 개인 업무용 소형 모델은 M6 16~24GB, 20GB급 모델을 상시로 돌리려면 M5 Pro 48~64GB가 맞습니다. 이 글의 구성·가격·전력은 2026년 10월 12일 애플 공식 사양 페이지, 모델 크기는 올라마 공식 라이브러리에서 확인한 값입니다.
맥미니는 지금 어떤 구성으로 팔리고, 얼마인가요?
2026년 10월 기준 맥미니는 M6 칩 3가지와 M5 Pro 칩 1가지, 총 4가지 기본 구성으로 나옵니다.
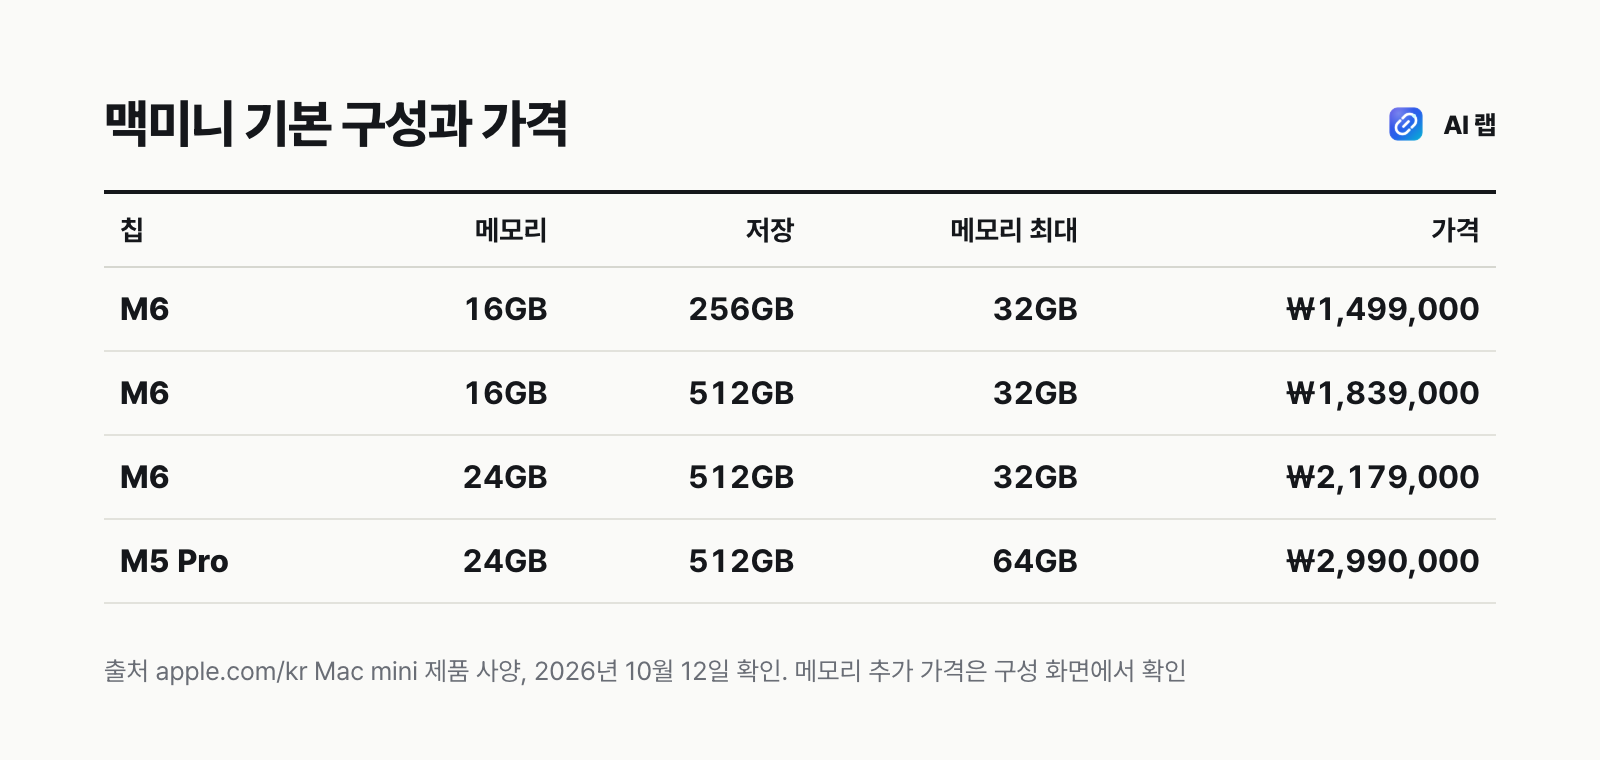
| 기본 구성 | 메모리 대역폭 | 늘릴 수 있는 메모리 | 가격 |
|---|---|---|---|
| M6 · 16GB · 256GB | 153GB/s | 24GB, 32GB | ₩1,499,000 |
| M6 · 16GB · 512GB | 153GB/s | 24GB, 32GB | ₩1,839,000 |
| M6 · 24GB · 512GB | 170GB/s | 32GB | ₩2,179,000 |
| M5 Pro · 24GB · 512GB | 307GB/s | 48GB, 64GB | ₩2,990,000 |
AI 용도에서 눈여겨볼 차이는 두 가지입니다. 메모리 상한(M6 32GB, M5 Pro 64GB)과 메모리 대역폭(M5 Pro가 약 2배)입니다. 메모리 추가 가격은 애플 스토어 구성 화면에서 고를 때 바로 표시되니 그 자리에서 확인하세요.
왜 맥미니 AI는 '통합 메모리'가 중요할까요?
일반 PC에서 AI 모델을 빠르게 돌리려면 모델을 그래픽카드 전용 메모리(VRAM)에 올려야 합니다. 애플 실리콘 맥은 CPU와 GPU가 한 메모리를 같이 쓰는 통합 메모리 구조라서, 32GB 맥이면 그 32GB를 GPU 연산에도 그대로 씁니다.
애플이 만든 머신러닝 프레임워크 MLX의 공식 문서도 이 점을 핵심 차이로 꼽습니다. 배열이 공유 메모리에 있어서 CPU와 GPU 사이에 데이터를 복사하지 않고 연산한다는 설명입니다. 애플은 새 맥미니가 GPU 코어마다 Neural Accelerator를 넣어 온디바이스 AI 모델 구동을 빠르게 한다고 밝히고 있습니다.
애플이 공개한 비교 수치도 있습니다. M6 맥미니는 M4 대비 최대 4.8배, M5 Pro는 M4 Pro 대비 최대 4배 빠르다고 하는데, 각주를 보면 4비트 14B 모델을 LM Studio로 8K 토큰 프롬프트를 넣었을 때 첫 토큰이 나오기까지의 시간을 잰 값입니다. 답 전체를 만드는 속도와는 다른 지표라는 점을 감안해서 보세요.
메모리 몇 GB면 어떤 모델이 들어가나요?
모델 크기는 공식 다운로드 용량으로 가늠하는 게 가장 정확합니다. 올라마 라이브러리의 Gemma 4(4비트 양자화 q4_K_M) 기준 용량은 다음과 같습니다.
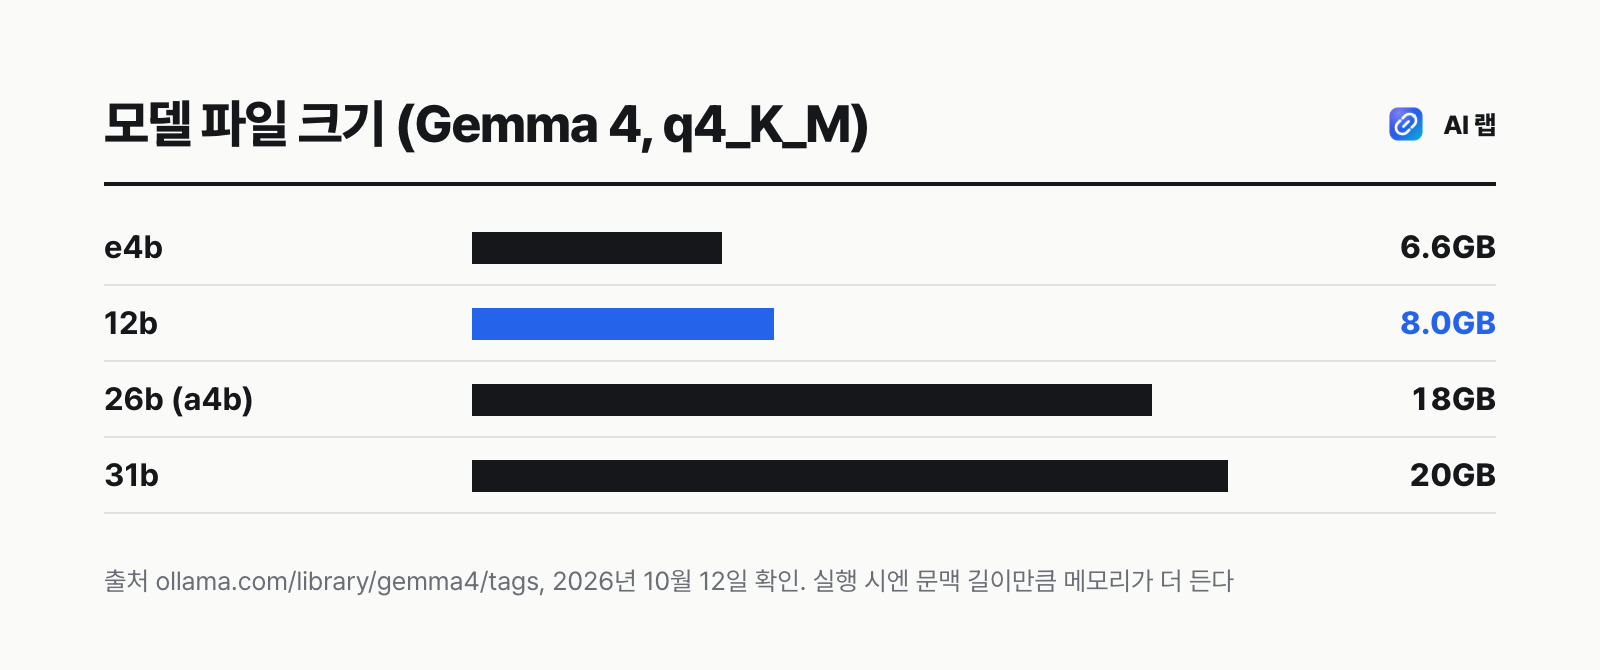
이 파일 크기에 운영체제와 브라우저 같은 다른 앱이 쓰는 메모리, 대화가 길어질수록 늘어나는 문맥 메모리가 더해집니다. 그래서 대략 이렇게 고르면 무리가 없습니다.
- 16GB: 6~8GB급 작은 모델(e4b, 12b). 요약·번역·초안 같은 가벼운 업무
- 24~32GB: 12b를 여유 있게, 18GB급 모델은 다른 앱을 줄이고
- 48~64GB(M5 Pro): 20GB급 모델을 상시로, 또는 여러 모델을 번갈아
LM스튜디오 공식 문서도 맥은 RAM 16GB 이상을 권장하고, 8GB는 작은 모델과 짧은 문맥용이라고 안내합니다. 모델 파일 크기와 실제 메모리 사용량은 ollama ps 같은 명령으로 직접 확인하는 게 가장 확실합니다.
맥미니에서 로컬 AI는 어떤 프로그램으로 돌리나요?
목적에 따라 셋 중 하나를 고르면 됩니다.
| 도구 | 맞는 사람 | 특징 |
|---|---|---|
| 올라마 | 명령어·서버 운영 | ollama run 한 줄, 애플 Metal 가속, 기본 포트 11434 |
| LM스튜디오 | 화면에서 고르고 비교 | 허깅페이스 검색, 애플 실리콘에서 MLX 실행 |
| MLX(mlx-lm) | 파이썬으로 직접 | pip install mlx-lm 후 mlx_lm.chat |
설치와 명령은 올라마로 로컬 LLM 돌리기와 LM스튜디오 사용법에 단계별로 정리해 두었습니다. 둘 다 OpenAI 호환 API를 주기 때문에, 맥미니를 집이나 사무실 안의 작은 AI 서버로 두고 다른 컴퓨터의 앱에서 붙여 쓸 수도 있습니다. 다만 올라마는 기본으로 자기 컴퓨터(127.0.0.1)에서만 요청을 받으므로, 다른 기기에서 쓰려면 OLLAMA_HOST 설정을 바꿔야 하고 그만큼 같은 네트워크 안의 누구나 접근할 수 있게 된다는 점도 함께 고려해야 합니다.
MLX를 직접 쓰는 경우 공식 저장소 기준 시작은 이렇습니다.
pip install mlx-lm
mlx_lm.chat   # 기본 모델: mlx-community/Llama-3.2-3B-Instruct-4bit
맥미니를 AI 서버로 24시간 켜 두면 전기는 얼마나 쓰나요?
애플 사양 페이지에 적힌 전력 수치는 다음과 같습니다.
- 표준 연간 소비전력: 모델 A3534 12.8kWh, A3535 16.5kWh
- 슬립모드 소비전력: 0.8~0.9W, 오프모드 0.2W
- 최대 연속 출력: 155W
표준 연간 소비전력은 정해진 사용 패턴 기준의 값이라, AI 모델을 계속 돌리는 상황에서는 이보다 많이 씁니다. 그래도 최대 연속 출력이 155W로 표기돼 있어 일반 데스크톱 GPU 서버와 비교하면 전력 부담이 작은 편입니다. 상시 서버로 쓸 거라면 유선 이더넷(기본 2.5Gb)으로 연결하고, 원격 접속 시 외부에 포트를 그대로 열지 않는 것부터 챙기세요.
M6와 M5 Pro, 맥미니 AI용으로는 무엇을 사야 할까요?
가격 차이가 큰 만큼 용도를 먼저 정하고 고르는 게 좋습니다. 애플 공식 사양을 AI 용도 기준으로 다시 놓으면 이렇습니다.
| 이런 용도라면 | 추천 구성 | 이유 |
|---|---|---|
| 혼자 쓰는 요약·번역·초안 | M6 16GB | 6~8GB급 모델이면 충분, 가장 저렴(₩1,499,000) |
| 문서 질의응답, 12b급을 여유 있게 | M6 24~32GB | 모델과 다른 앱을 같이 띄울 여유 |
| 20GB급 모델 상시, 팀 공용 서버 | M5 Pro 48~64GB | 메모리 상한 64GB, 대역폭 307GB/s |
판단 기준은 세 가지입니다. 첫째, 지금 쓰려는 모델보다 한 단계 큰 모델을 넣을 수 있는지 봅니다. 공개 모델은 계속 커지고, 맥미니 메모리는 산 뒤에 늘릴 수 없습니다. 둘째, 칩 등급입니다. M5 Pro는 메모리 대역폭(307GB/s)이 M6의 약 2배이고 CPU·GPU 코어도 더 많아, 큰 모델을 여러 사람이 함께 쓰는 서버라면 M5 Pro 쪽이 여유가 있습니다. 실제 속도는 모델과 설정마다 달라서 공식 수치가 없으니, 가능하면 매장 체험이나 반품 기간 안에 쓰려는 모델로 직접 확인하세요. 셋째, 저장 공간입니다. 모델 하나가 6~20GB라 여러 개를 받아 두면 256GB는 금방 찹니다. 모델을 여러 개 비교할 계획이라면 512GB 이상 구성이 편합니다.
맥미니 AI가 API보다 나은 경우는 언제인가요?
비용만 보면 API가 생각보다 쌉니다. 가장 저렴한 API 모델은 100만 토큰당 입력 $0.10, 출력 $0.50 수준이라(OpenAI API 가격 정리), 가끔 쓰는 정도로는 149만9천원짜리 맥미니 값을 회수하기 어렵습니다. 맥미니가 유리한 경우는 따로 있습니다.
- 데이터를 밖으로 보내면 안 될 때: 고객 정보·내부 문서를 외부 서버로 보내지 않고 처리
- 매일 대량으로 돌릴 때: 문서 분류·요약을 하루 종일 돌려도 추가 요금이 없음
- 이미 맥미니가 있을 때: 추가 비용 없이 바로 시작
토큰이 무엇이고 비용이 어떻게 계산되는지는 LLM이란? 토큰과 비용 계산에 정리했습니다.
맥미니 AI가 맞지 않는 경우는?
- 가장 똑똑한 모델이 필요할 때: 로컬에서 돌리는 공개 모델은 최상위 클라우드 모델과 같은 성능을 내지 않는 경우가 많습니다. 품질이 우선이면 API가 맞습니다.
- 메모리를 나중에 늘리려는 경우: 맥미니 메모리는 살 때 구성해야 합니다. 큰 모델을 쓸 계획이 있다면 처음부터 넉넉하게 고르세요.
- 여러 사람이 동시에 쓰는 서비스: 한 대로 많은 요청을 동시에 처리하기는 어렵습니다. 이 경우엔 클라우드 서버나 API를 섞어 쓰는 구성이 현실적입니다.
정리: 맥미니 AI는 이렇게 시작하세요
- 돌릴 모델의 다운로드 용량을 먼저 확인하고, 그보다 넉넉한 메모리 구성을 고릅니다(소형 16~24GB, 20GB급 상시 48~64GB).
- 올라마나 LM스튜디오로 작은 모델부터 받아 업무에 맞는지 봅니다.
- 데이터 보안·대량 처리가 목적이면 로컬, 가끔·고품질이 목적이면 API로 나눕니다.
사내 AI 서버나 이를 붙인 서비스를 만들 계획이라면 구성부터 함께 검토해 드립니다.